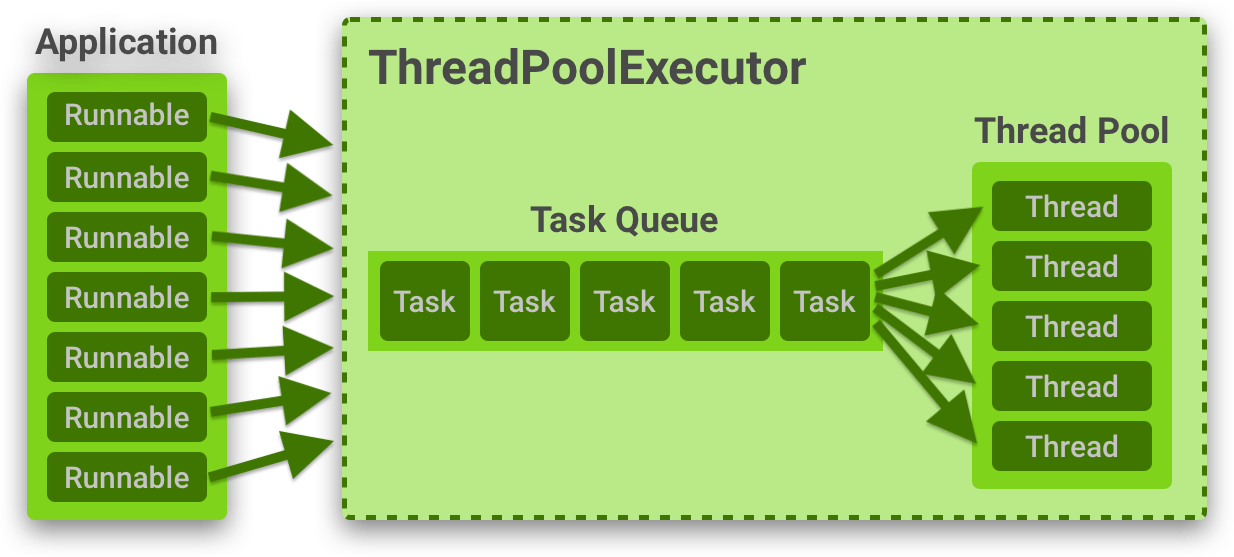
ThreadPoolExecutor의 execute() 동작 순서를 보면, corePoolSize와 maximumPoolSize에 따라 대략 다음과 같이 동작한다.
- 현재 스레드 풀의 워커 수가 corePoolSize보다 작다면, 새로운 스레드를 생성하고 제출된 작업을 즉시 실행한다.
- 그게 아니라면 작업을 대기열 큐에 넣는다.
- 큐에도 더 이상 넣을 수 없다면, maximumPoolSize까지는 스레드를 추가로 생성해 작업을 처리한다.
- 그것마저 불가능하면 작업을 거부한다.
여기서 한 가지 애매하게 느껴지는 부분이 있었다.
3번에서 “스레드를 생성하여 작업을 실행한다”는 것은
방금 제출한 작업을 즉시 실행한다는 뜻일까?
아니면
큐에 쌓여 있던 작업을 꺼내서 실행한다는 뜻일까?
스레드가 늘어나는 것 자체는 이해가 되는데,
정작 그 새 스레드가 어떤 작업을 먼저 실행하는지가 헷갈렸다.
테스트
직접 테스트 해봤다.
public class ThreadOrderTest {

    public static void main(String[] args) {

        ThreadPoolExecutor threadPoolExecutor = new ThreadPoolExecutor(
                3, // corePoolSize
                5, // maximumPoolSize
                10000, // keepAliveTime
                TimeUnit.MILLISECONDS, // TimeUnit
                new LinkedBlockingQueue<>(3) // 작업 큐 크기 = 3
        );

        try {
            for (int i = 1; i <= 9; i++) {
                try {
                    threadPoolExecutor.submit(new Task(i));
                    System.out.println(i + "번째 task submit 완료 후 Pool 에 존재하는 스레드 수 : " + threadPoolExecutor.getPoolSize());
                    System.out.println("작업 큐 사이즈 : " + threadPoolExecutor.getQueue().size());
                } catch (RejectedExecutionException re) {
                    System.out.println("작업 " + i + "가 거부됨 : maxPoolSize 를 초과할 수 없음.");
                    break;
                }
            }
        } finally {
            threadPoolExecutor.shutdown();
        }
    }

    static class Task implements Runnable {

        private final int number;

        public Task(int number) {
            this.number = number;
        }

        @Override
        public void run() {
            try {
                System.out.println("number = " + number + " task 실행 중");
                Thread.sleep(1000);
            } catch (InterruptedException e) {
                throw new RuntimeException(e);
            }
        }
    }
}
Task 클래스에 number 필드를 추가해서, 각 작업이 자신의 번호를 출력하도록 만들었다.
이렇게 하면 어떤 작업이 실제로 먼저 실행되는지를 눈으로 확인할 수 있다.
실행 결과
number = 1 스레드 실행 중
1번째 task submit 완료 후 Pool 에 존재하는 스레드 수 : 1
작업 큐 사이즈 : 0
2번째 task submit 완료 후 Pool 에 존재하는 스레드 수 : 2
number = 2 스레드 실행 중
작업 큐 사이즈 : 0
3번째 task submit 완료 후 Pool 에 존재하는 스레드 수 : 3
number = 3 스레드 실행 중
작업 큐 사이즈 : 0
4번째 task submit 완료 후 Pool 에 존재하는 스레드 수 : 3
작업 큐 사이즈 : 1
5번째 task submit 완료 후 Pool 에 존재하는 스레드 수 : 3
작업 큐 사이즈 : 2
6번째 task submit 완료 후 Pool 에 존재하는 스레드 수 : 3
작업 큐 사이즈 : 3

===== 이 아래부터 핵심 =====

7번째 task submit 완료 후 Pool 에 존재하는 스레드 수 : 4
number = 7 스레드 실행 중
작업 큐 사이즈 : 3
8번째 task submit 완료 후 Pool 에 존재하는 스레드 수 : 5
작업 큐 사이즈 : 3
number = 8 스레드 실행 중
작업 9가 거부됨 : maxPoolSize 를 초과할 수 없음.
number = 5 스레드 실행 중
number = 4 스레드 실행 중
number = 6 스레드 실행 중
핵심은 마지막 부분이다.
7번째, 8번째 작업을 제출했을 때는 이미 대기열 큐가 가득 차 있었기 때문에,
ThreadPoolExecutor는 새로운 스레드를 생성하게 된다.
그런데 여기서 중요한 점은, 새로 생성된 스레드가 큐에 있던 4, 5, 6번 작업을 먼저 실행한 것이 아니라
방금 submit한 7번, 8번 작업을 즉시 실행했다는 것이다.
즉, 큐가 꽉 찼을 때 추가로 생성된 스레드는
큐에 쌓인 작업을 소비하러 가는 것이 아니라, 지금 막 제출된 작업을 바로 실행한다.
왜 이런 일이 발생할까?
이건 ThreadPoolExecutor의 execute() 구현을 보면 확인할 수 있다.
public void execute(Runnable command) {
        if (command == null)
            throw new NullPointerException();
        /*
         * Proceed in 3 steps:
         *
         * 1. If fewer than corePoolSize threads are running, try to
         * start a new thread with the given command as its first
         * task.  The call to addWorker atomically checks runState and
         * workerCount, and so prevents false alarms that would add
         * threads when it shouldn't, by returning false.
         *
         * 2. If a task can be successfully queued, then we still need
         * to double-check whether we should have added a thread
         * (because existing ones died since last checking) or that
         * the pool shut down since entry into this method. So we
         * recheck state and if necessary roll back the enqueuing if
         * stopped, or start a new thread if there are none.
         *
         * 3. If we cannot queue task, then we try to add a new
         * thread.  If it fails, we know we are shut down or saturated
         * and so reject the task.
         */
        int c = ctl.get();
        if (workerCountOf(c) < corePoolSize) {
            if (addWorker(command, true))
                return;
            c = ctl.get();
        }
        if (isRunning(c) && workQueue.offer(command)) {
            int recheck = ctl.get();
            if (! isRunning(recheck) && remove(command))
                reject(command);
            else if (workerCountOf(recheck) == 0)
                addWorker(null, false);
        }
        else if (!addWorker(command, false))
            reject(command);
    }
여기서 눈여겨봐야 하는 메서드는 addWorker(task, useCore) 다.
이 메서드는:
- Runnable을 전달받으면 그 작업을 첫 번째 작업으로 즉시 실행하고
- null을 전달받으면 큐에서 작업을 꺼내 실행하는 워커를 생성한다고 이해할 수 있다
그렇다면 큐가 가득 찬 상황은 어디일까?
바로 이 부분이다.
else if (!addWorker(command, false))
reject(command);
즉,
- 현재 큐는 가득 차 있고
- 아직 maximumPoolSize까지는 여유가 있으므로
- 새 워커를 하나 더 만들 수 있는 상황이다
이때 addWorker()에 전달되는 인자는 command,
즉 방금 execute()에 넘긴 그 작업 자체다.
따라서 새로 생성된 스레드는 큐에 있던 작업을 꺼내는 것이 아니라, 방금 제출된 작업을 자신의 첫 작업으로 즉시 실행하게 된다.
정리
헷갈렸던 포인트를 한 문장으로 정리하면 이렇다.
작업 큐가 가득 찼고, 아직 maximumPoolSize에는 도달하지 않았다면,
새로 만들어진 스레드는 큐의 작업이 아니라 방금 제출된 작업을 바로 실행한다.
즉, 큐가 꽉 찼을 때의 추가 스레드 생성은
밀려 있는 큐 작업을 소화하기 위한 스레드 생성이라기보다,
현재 제출된 작업을 더 이상 큐에 못 넣으니, 새 워커를 붙여서 바로 처리하는 방식에 가깝다.
3줄 요약
- 대기열이 꽉 찼지만 아직 maximumPoolSize보다 작으면 새 스레드를 만들 수 있다.
- 이때 새 스레드는 큐에 있던 작업이 아니라, 방금 제출된 작업을 바로 실행한다.
- 이유는 execute()가 그 상황에서 addWorker(command, false)를 호출하기 때문이다.